
上一篇把實作的部分都說明完了,今天要來看看報告的內容,尤其是第五章由 AI 整理的 findings 與選圖結果品質如何。
這次測試的目標是模擬發薪日情境,讓 1,000 位使用者在一分鐘內登入,接著沿用 session 持續執行查詢帳戶、查詢餘額、查詢收款帳戶、轉帳與查詢交易紀錄。
壓測時間為 15 分鐘。每個服務都只有一個副本,也沒有設定 HPA。這個配置沒有水平擴充空間,正好可以拿來看 AI 能不能從取得的資訊裡整理出有用的注意事項。
這份報告固定分成五章。前四章由程式根據 bundle.json 產生,第五章開頭的流量結果也是程式產生,後面的四項 findings 才是 AI 分析的內容。
第一章列出測試 ID、環境、測試類型、目的與測量時間。開頭直接寫明本次測試未通過,共有四項驗收條件需要處理。
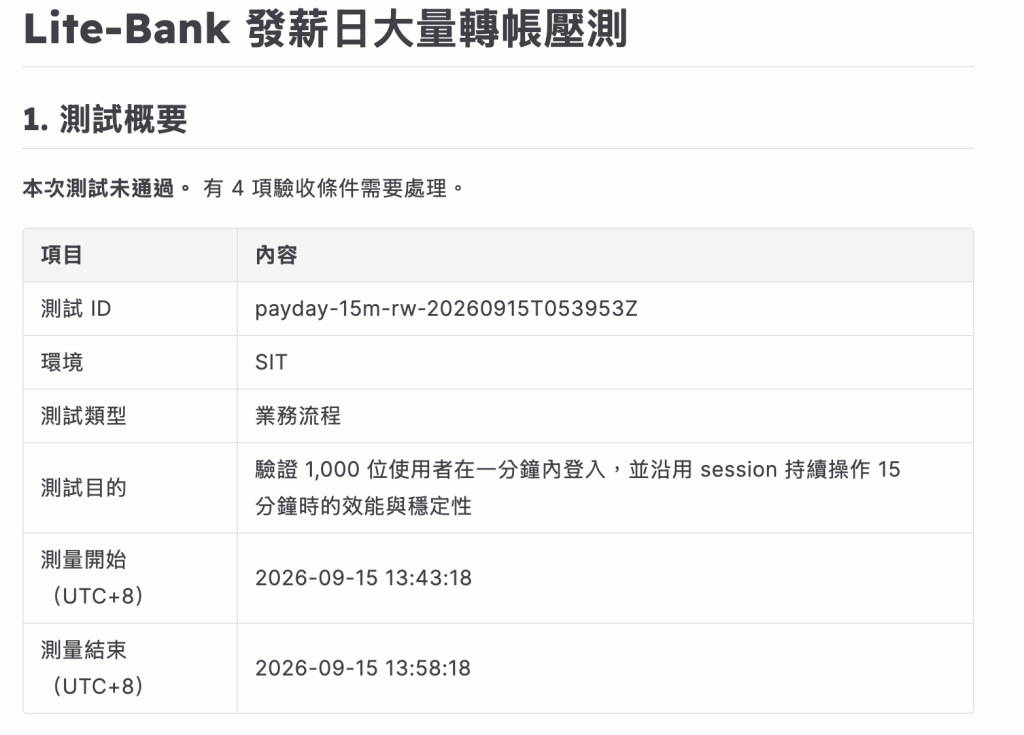
這一章可以讓看報告的人快速知道測了什麼、何時測,以及最後有沒有通過。內容全部來自 bundle.json,程式照資料產生即可。
第二章整理五個服務的 CPU、記憶體、副本數、HPA、Hikari connection pool 與 Tomcat threads 設定。
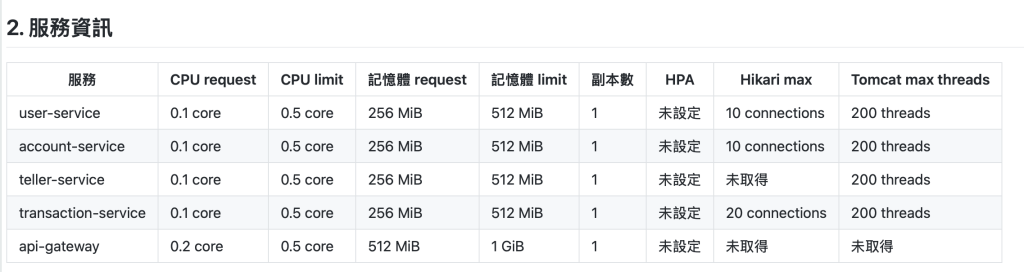
從這些配置可以知道當時壓測的設定。例如 user-service 的 CPU limit 只有 0.5 core,Hikari max 是 10 connections,而且只有一個副本。看到 CPU throttling、連線等待或 Pod 重啟時,讀者可以直接回來對照當時的資源上限。
第三章列出本次壓測的七項驗收條件。本次有四項未通過:HTTP 錯誤率、登入 P99、交易紀錄查詢 P99 與轉帳 P99。
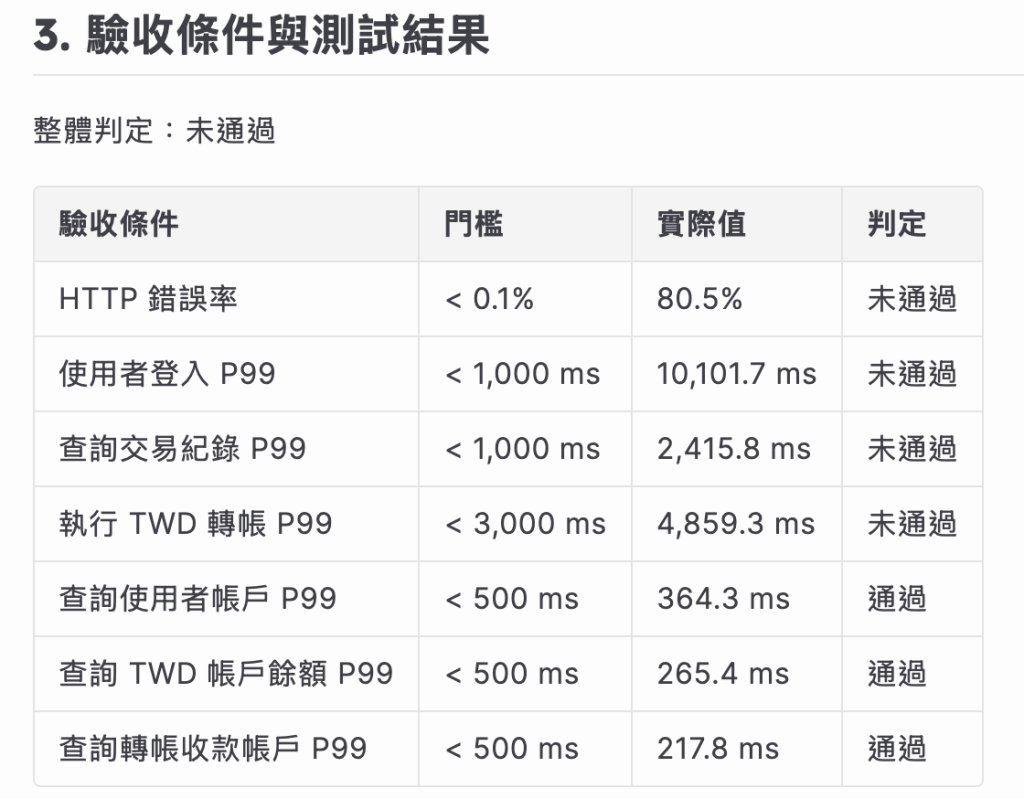
這裡的判定早在產生報告前就已經完成。報告程式只負責顯示門檻、實際值與判定,不會讓 AI 自己決定 PASS 或 FAIL。
第四章記錄 k6 使用固定到達率,在一分鐘內啟動 1,000 次流程,VU 預先配置與上限都是 1,001。
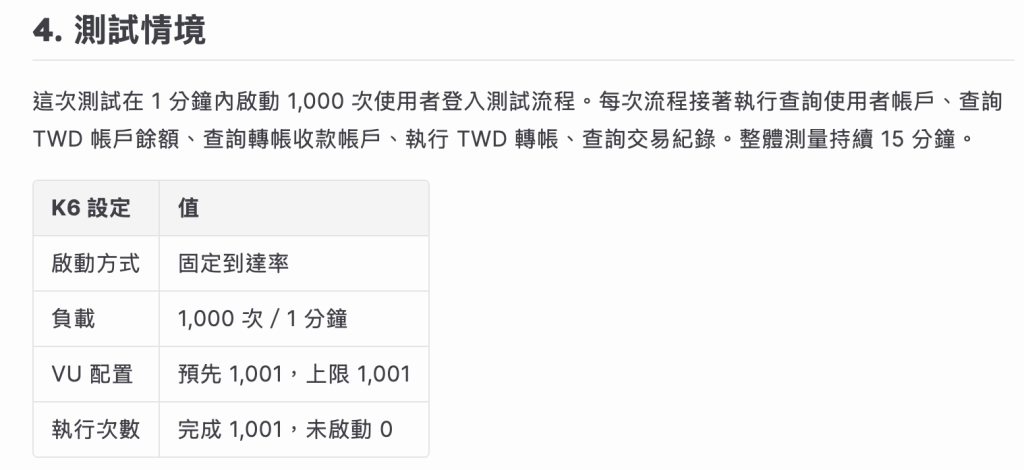
前四章都是程式根據結果產生的。我們來看看第五章的後半部,AI 從這裡開始參與內容判讀。
第五章開頭先抓出最明顯的結果:登入 check 共執行 1,000 次,只有 43 次成功,957 次失敗,成功率只剩 4.3%。
接著列出整體流量結果。整場測試共有 1,236 個 HTTP requests,錯誤率 80.5%,P99 約 10 秒。最後只有 5 次完整流程跑完,轉帳完成次數則是 0。
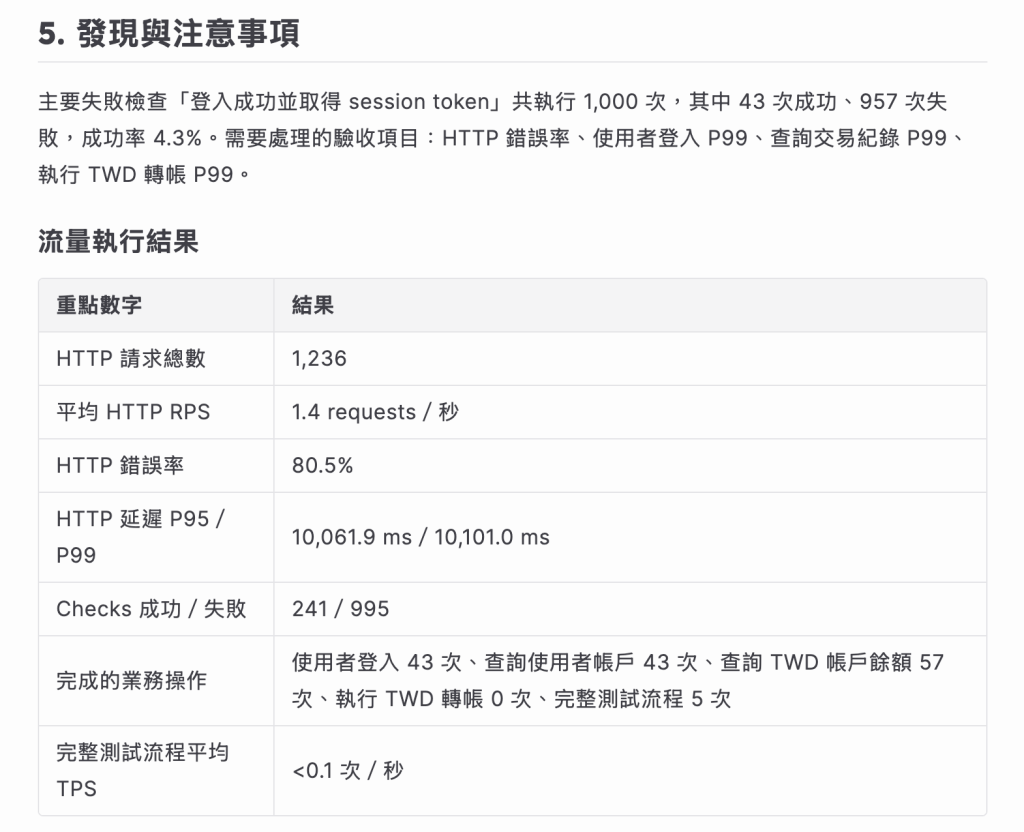
這一段仍由程式產生。後面再由 AI 解釋值得注意的現象。
AI 的第一項 finding 將登入失敗、user-service CPU throttling 與 Pod 重啟放在一起。
登入 P99 是 10,101.7 ms,整場 HTTP 錯誤率是 80.5%。測量開始後不久,user-service 的 CPU 使用量已接近 0.5 core limit,CPU throttling 比例接近 100%。同一段時間內,restart counter 從 1 變成 2,Ready replicas 也曾降到 0。
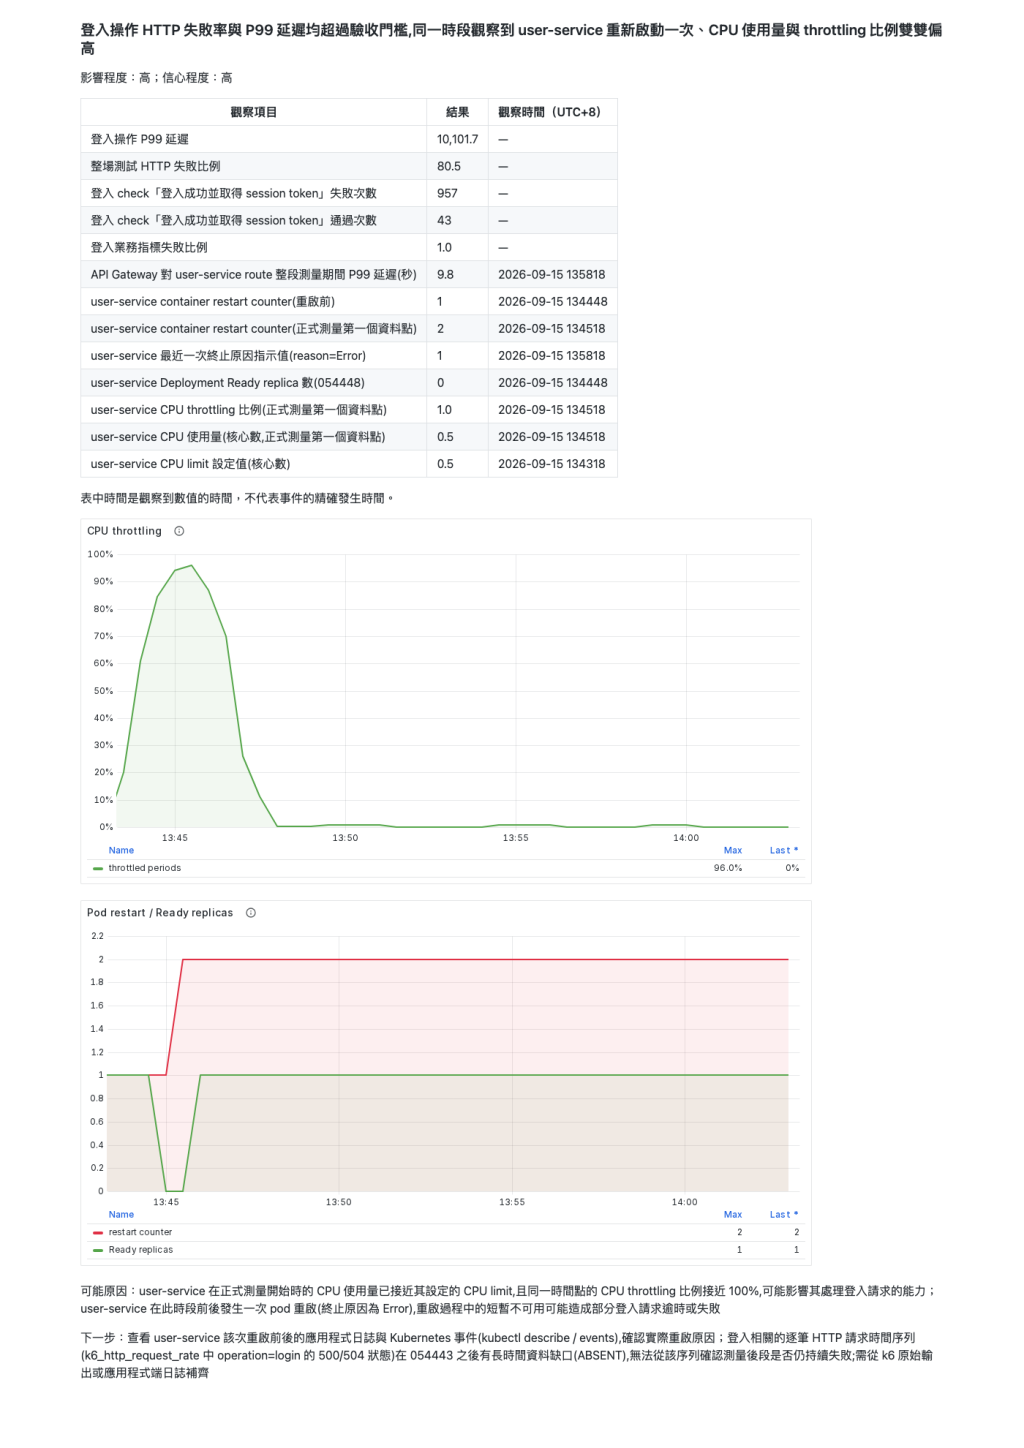
我覺得這一段寫得還行。AI 沒有直接說 CPU throttling 就是根因,文字保留了「可能影響」與「可能造成」的說法。下一步也有要求查看應用程式 log 與 Kubernetes events,繼續確認實際重啟原因。
這兩張圖也選得合理。CPU throttling 圖顯示測量前段一度接近 100%,Pod restart 圖則顯示 restart counter 從 1 變成 2(測試前已經重啟過一次,所以原數值是 1)、Ready replicas 短暫掉到 0。兩張圖放在一起,可以讓讀者快速看到異常集中在測試剛開始的時間附近。
不過,這些證據目前只能確認事件發生在相近時段。登入請求、CPU throttling 與 Pod 重啟之間的先後順序和因果關係,還需要人從 log、event 或 trace 才能判斷。
第二項 finding 是轉帳 P99 超過 3 秒門檻,而且 38 次轉帳 check 全部失敗。
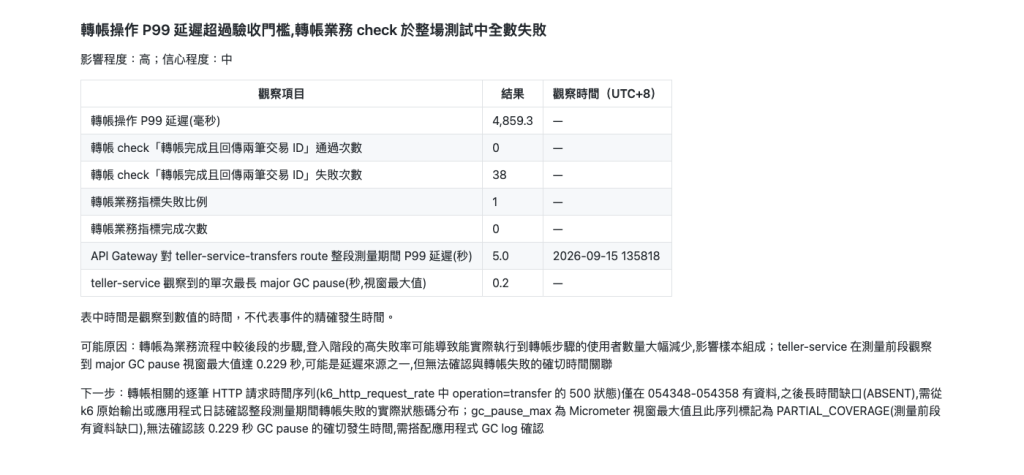
這一段有抓到轉帳位在業務流程後段,登入只成功 43 次,實際能走到轉帳步驟的使用者已經很少。此時的轉帳結果無法代表原本規劃的 1,000 位使用者情境,樣本組成早就受到前段失敗影響。
AI 也提到 teller-service 的 major GC pause 最大值為 0.229 秒,但它沒有把兩件事直接接成因果,還明確寫下無法確認時間是否重合。這個判斷相對保守,信心程度標成「中」也合理。
這項 finding 沒有附圖。候選清單裡其實有轉帳 P99 Panel,AI 在三張圖的額度中把兩張給了登入問題,最後沒有選它。如果 Dashboard 再補上轉帳狀態碼分布與 operation request rate 等 Panel,這一段會更容易判讀。
第三項 finding 指出交易紀錄查詢的中位數只有 23.2 ms,P99 卻達到 2,415.8 ms,最大值則是 2,662.8 ms。這代表大部分請求很快,少數請求拖出明顯的 long tail latency,也就是尾端延遲。
同一個測量期間內,transaction-service 等待從 Hikari connection pool 取得資料庫連線的時間曾達 4.5 秒。AI 將資料庫連線等待列為可能原因,並建議查看延遲或 trace,確認兩個事件的時間是否重合。這段沒有把可能原因直接寫成結論,尺度抓得合理。
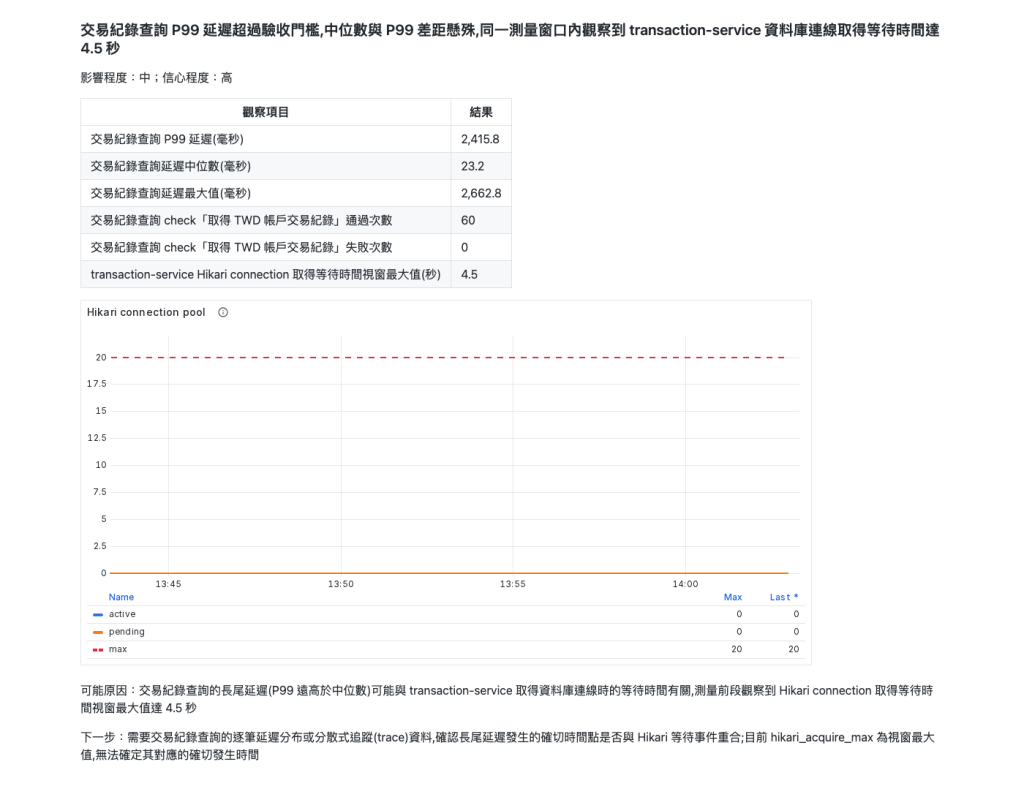
問題出在圖片。AI 選到的是「Hikari connection pool」Panel,圖中只有 active connections、pending connections 與 max connections。整段期間 active 和 pending 都是 0,max 固定是 20。
文字要說明的是等待從 Hikari connection pool 取得資料庫連線的時間曾達 4.5 秒,圖片卻完全沒有這條指標。讀者從圖上看不到 4.5 秒,也無法用這張圖檢查 long tail latency 與連線等待是否同時發生。
這結果是 AI 有選到相關元件,卻沒有選到能回答 finding 的圖。
最後一項 finding 是 transaction-service 的 memory working set,從測量開始的 350,953,472 bytes 上升到測量結束的 397,336,576 bytes,恢復期最高值為 397,553,664 bytes。
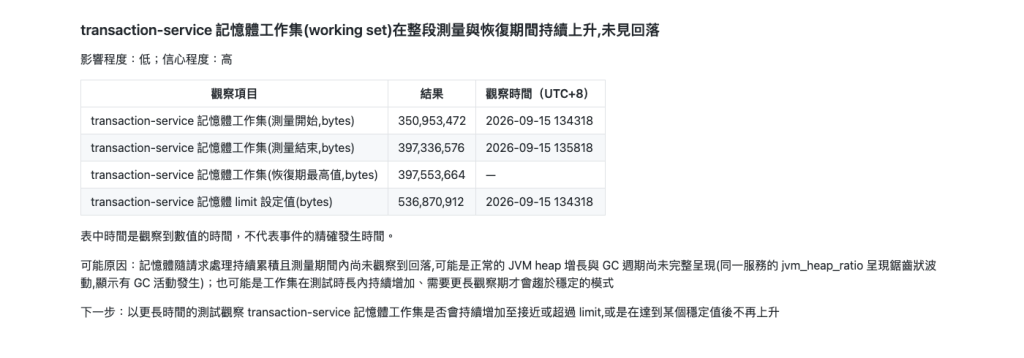
AI 沒有直接把記憶體上升判定為 memory leak。這可能只是 JVM 執行期間逐步使用記憶體,也可能是測試時間太短,還看不出 GC 後記憶體是否會下降。需要拉長測試時間,才能確認記憶體最後會維持在固定範圍,還是繼續往 limit 增加。影響程度標成「低」,我覺得合理。
這項 finding 同樣沒有附圖。候選清單中已經有 memory working set Panel,AI 因為三張圖的額度與 finding 優先順序而放棄它。雖然這段很適合用 time series 呈現,但影響程度標為「低」,三張圖優先留給影響程度較高的 finding,這次沒選還算可以。
整體看完,我覺得它已經能當成第一版壓測檢視報告,QA 可以接著複核內容與選圖,再做必要調整。
AI 有抓到四個值得追查的方向,也知道把已知事實、可能原因與建議的下一步分開,但流程和結果還有很多可以改善的地方。
特徵化後仍保留大量降採樣的 metrics 與時間序列。提示詞雖然要求 AI 觀察趨勢,目前仍無法確認它是否真的理解資料點之間的時間關係。這些資料也占用大量 context,效益還要再評估。
接續上一點,這次的 bundle.json 實際有 2.14 MB。每次都把完整 Bundle 交給 AI,會消耗大量 context 與 token,其中還包含前四章可由程式直接處理的資料。後續要思考如何縮減資料,同時保留重要資訊。
Dashboard Panel 不夠完整。這次缺少資料庫連線等待時間與 HTTP status 分布,導致圖片對不到 finding。後續要先確認提供給 AI 分析的 metrics,再補上對應的 Panel,AI 才有適合的圖可以選。
報告中的數值應先由程式轉成容易閱讀的單位,例如將 bytes 換算成 MiB。否則 AI 很可能直接照抄原始數值,讀者還要自己換算。
目前最多只能選三張圖,原本是怕圖片太多讓報告太冗長。但如果重要 findings 超過三項,沒有附圖也很可惜。圖表數量的上限要怎麼拿捏,還要再想想。
這套流程能不能真的減少 QA 寫壓測報告的時間,還要多跑幾次才知道。
壓測報告與 AI 分析先告一段落,下一篇換個主題。
今天就先寫到這,我們明天見!


 iThome鐵人賽
 看影片追技術